Inżynieria kontekstowa wymaga pętli sprzężenia zwrotnego
Wszyscy tworzą pliki CLAUDE.md i AGENTS.md, a następnie pozwalają im popadać w zapomnienie. Inżynieria kontekstowa nie posiada cyklu konserwacji. Agent, który właśnie natrafił na nieaktualny dokument, jest tym, który może go poprawić.
Inżynieria kontekstowa to dziedzina zajmująca się dostarczaniem agentowi sztucznej inteligencji odpowiednich informacji, w odpowiedniej formie i we właściwym czasie, tak aby mógł on wykonywać swoją pracę prawidłowo, zamiast polegać na domysłach. W praktyce dla większości zespołów oznacza to pliki: plik CLAUDE.mdw katalogu głównym repozytorium, plik AGENTS.md, folder zawierający zasady i konwencje oraz komunikat systemowy, który ktoś kiedyś dostosował. Opisują Państwo sposób działania projektu, aby agent nie musiał go na nowo odkrywać przy każdej sesji.
To naprawdę najskuteczniejszy sposób, jaki można zastosować, aby agenci byli użyteczni. Niemal każdy, kto to robi, boryka się z tym samym niewypowiedzianym problemem: pliki te tracą aktualność, a nikt nie wie, które ich fragmenty. Kontekst został napisany raz, kod ewoluował, a teraz połowa tych informacji jest po cichu nieaktualna. W tej dziedzinie istnieje etap wprowadzania danych i opisywania kontekstu, ale brakuje pętli konserwacyjnej. Właśnie tej luki dotyczy niniejszy wpis.
Kontekst to kod, a kod ulega degradacji
Wiemy już, że dokumentacja traci na aktualności. Udokumentowany przez Państwa etap kompilacji zostaje zastąpiony, opisany przez Państwa folder otrzymuje nową nazwę, zapisana przez Państwa konwencja zostaje unieważniona, a dokumentacja nadal z przekonaniem opisuje przeszłość. Pliki kontekstowe są pod tym względem gorsze od zwykłej dokumentacji z dwóch powodów.
Po pierwsze, agent interpretuje je dosłownie i działa zgodnie z nimi. Człowiek przegląda nieaktualny plik README, wyczuwa, że coś tu nie gra, i zwraca się z pytaniem do kogoś. Agent traktuje to dosłownieCLAUDE.md. Jeśli w pliku jest napisane „uruchom make setup” , a dany cel został usunięty w poprzednim kwartale, agent nie zwraca na to uwagi. Marnuje czas, próbując sprawić, by nieprawidłowe polecenie zadziałało, albo wymyśla obejście i kontynuuje pracę, przenosząc błędną instrukcję do swoich wyników.
Po drugie, nieprawidłowy kontekst jest gorszy niż brak kontekstu. W przypadku luki agent potrafi czasem wywnioskować brakujące informacje lub je zasygnalizować. Natomiast w przypadku błędnego stwierdzenia, co do którego jest przekonany, polega na nim. Najbardziej kosztowne wiersze w Państwa plikach kontekstowych to nie te, których brakuje, lecz te, które kiedyś były prawdziwe.
 ]
Potrzebna jest więc pętla konserwacyjna. Problem polega na tym, że typowe rozwiązania nie sprawdzają się. Nie przeprowadzi Pan audytu CLAUDE.mdwiersz po wierszu zgodnie z harmonogramem. Nikt tego nie robi. Z zewnątrz nie zauważy Pan, że kod jest nieaktualny, ponieważ czyta się go bez problemów. Nieaktualność ujawnia się dopiero w momencie użycia, dla tego, kto z niego korzysta. A coraz częściej tym, kto z niego korzysta, nie jest człowiek.
Jedyny świadek, który o tym wie
Oto sedno sprawy. Agent, który właśnie przeprowadził sesję w ramach Państwa projektu, jest jedynym uczestnikiem, który wie konkretnie, które elementy Państwa kontekstu okazały się pomocne, a które wprowadziły go w błąd. Wykorzystał on po prostu pliki. Wydał polecenie kompilacji, które okazało się nieaktualne. Znalazł folder, który nie istnieje. Postępował zgodnie ze wzorcem, który okazał się składać z trzech wzorców. Ta wiedza istnieje mniej więcej tak długo, jak trwa sesja, a potem znika.
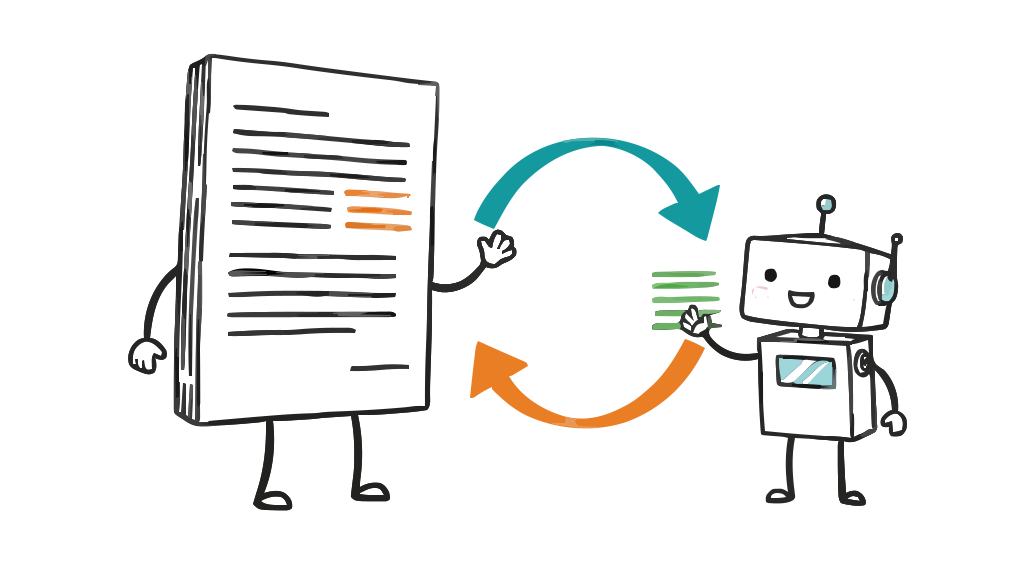
Nikt nie wskaże Panu, który kontekst jest niekompletny lub błędny, z wyjątkiem samego systemu, który właśnie na tym ucierpiał. To właśnie pętla sprzężenia zwrotnego – znajduje się tuż obok, a nikt z niej nie korzysta. Wystarczy poprosić agenta o zapisanie tego, czego się nauczył, przed zakończeniem sesji, i sformułować prośbę w taki sposób, aby wynik wskazywał bezpośrednio na pliki wymagające edycji.
Dziennik retrospektywny sesji stanowi pętlę konserwacyjną
Właśnie to zapewnia podsumowanie sesji generowane przez sztuczną inteligencję. Pod koniec sesji roboczej agent sporządza krótki, szczery wpis: co poszło dobrze, gdzie wystąpiły trudności oraz – co ma tutaj kluczowe znaczenie – każda trudność jest oznaczona jedną z dziesięciu stałych etykiet określających przyczynę źródłową, a wpis kończy się adnotacją „→ Rozwiązanie:” w formacie zgłoszenia. Dwie z tych dziesięciu etykiet odnoszą się bezpośrednio do Państwa plików kontekstowych:
missing-documentation****: agent potrzebował informacji, które powinny były zostać udokumentowane w ramach projektu, a nie zostały. Jest to lista zadań do opracowania zawarta w Państwa pliku kontekstowym. Każda z tych pozycji stanowi wiersz, któryCLAUDE.mdpowinni Państwo dodać do dokumentacji.incorrect-documentation****: dokumentacja istniała, ale zawierała błędy lub była nieaktualna. Jest to lista elementów do poprawienia w Państwa pliku kontekstowym. Każda z tych pozycji to nieaktualna linia, którą agent wykrył w jedyny możliwy sposób: korzystając z niej i napotykając przeszkodę.
Dodajcie jeszcze trzeci element, a pokryjecie większość czynności konserwacyjnych, jakich kiedykolwiek będziecie potrzebować: ambiguous-instruction****, czyli sytuacje, w których treść dokumentu lub zasady można interpretować na więcej niż jeden sposób. To właśnie ta pętla. Nie przeprowadza się audytu plików kontekstowych zgodnie z harmonogramem; pozwala się agentom, którzy z nich korzystają, aby w momencie użycia wskazali dokładnie, które wiersze należy zmienić, wraz z załączonymi dowodami, ponieważ praktyka ta opiera się wyłącznie na przytoczonych dowodach.
 ]
Istnieje też czwarty sygnał, który łatwo przeoczyć: przypuszczenia. Dobry wpis zawiera wykaz wszystkich miejsc, w których agent wypełnił lukę za pomocą przypuszczenia. Każde przypuszczenie to miejsce, w którym kontekst był na tyle skąpy, że agent musiał wymyślić odpowiedź. Przejrzyj domysły z całego tygodnia, a otrzymasz listę zadań dotyczących Państwa plików kontekstowych, której sam nigdy by Pan/Pani nie sporządził(a), ponieważ znają Państwo już odpowiedzi i dlatego nie dostrzegają Państwo, gdzie ich brakuje.
Oto przykładowy format zwracanych wyników. Jest to przykład ilustracyjny, a nie rzeczywiste dane:
## Friction
- CLAUDE.md says "run `make setup`" but that target was removed; the
  actual setup is `pnpm install && pnpm db:migrate`. Lost ~10 min.
  (incorrect-documentation)
  → Fix: Update the "Getting started" block in CLAUDE.md to the pnpm commands.
- Nothing documents that integration tests need the worker running.
  Found it by reading the CI config. (missing-documentation)
  → Fix: Add a "Running tests" note naming `pnpm worker` as a prerequisite.

## Guesses I made
- Assumed the `api/` package is the public surface and `internal/` is not,
  because nothing states it. Please confirm before I rely on it again.
Każda linia odpowiada konkretnej zmianie w konkretnym pliku. Jest to pętla konserwacyjna, którą osoba faktycznie uruchomi, ponieważ najbardziej czasochłonna część pracy – czyli zlokalizowanie problemu – została już wykonana.
Dlaczego to rozwiązanie jest lepsze od ręcznej kontroli
Można by spróbować aktualizować pliki kontekstowe w starym stylu: zaplanować przegląd, przeczytać je od początku do końca, zweryfikować każde stwierdzenie w świetle rzeczywistości. Tak się jednak nie dzieje, a nawet jeśli tak się dzieje, to jest to niewłaściwe narzędzie. Czytając dokument w oderwaniu od kontekstu, nie da się stwierdzić, które wiersze są nieaktualne. Wszystkie brzmią wiarygodnie. Nieaktualność ujawnia się dopiero podczas użytkowania. Dziennik retrospektywny to konserwacja kontekstu napędzana rzeczywistym użytkowaniem: oznaczane są wyłącznie te wiersze, które faktycznie spowodowały błąd agenta, dzięki czemu naprawia się to, co rzeczywiście nie działa, zamiast ponownie czytać to, co już jest w porządku. To różnica między czujnikiem dymu a przemierzaniem budynku w poszukiwaniu dymu.
Efekt ten ma charakter kumulacyjny. Proszę poprawić te incorrect-documentationelementy w tym tygodniu, a podczas sesji w przyszłym tygodniu napotkają Państwo mniej przeszkód, dzięki czemu dziennik ulegnie skróceniu, a uwaga skupi się na głębszych kwestiach. Państwa pliki kontekstowe stają się coraz dokładniejsze nie dlatego, że ktoś je poddał audytowi, ale dlatego, że osoby i agenci korzystający z nich mieli do dyspozycji prosty, ustrukturyzowany sposób zgłaszania odchyleń. To właśnie zdrowa współpraca między człowiekiem a sztuczną inteligencją: agent sygnalizuje odchylenie, a człowiek decyduje o zmianie. Ta sama pętla działa również między ludźmi: połączyliśmy prywatne zapisy „Claude Code” pięciu programistów i wdrożyliśmy zasady, które kilku z nas zapisało niezależnie.
Rozpocznij pętlę
Jeśli już inwestują Państwo w inżynierię kontekstową, oto brakujący element: pętla utrzymania, która zapobiega utracie wartości tej inwestycji. Jest to oprogramowanie typu open source na licencji MIT:
- Pobierz zestaw umiejętności i podpowiedzi: „github.com/TeamRetroHQ/teamretro-skills”: umiejętność Claude Code służąca do tworzenia wpisu na zakończenie sesji, umiejętność syntetyzująca wpisy w krótkie podsumowanie oraz zestaw podpowiedzi niezależny od narzędzia, przeznaczony dla Cursor, GitHub Copilot lub dowolnego agenta, któremu można podawać polecenia.
- Zapoznaj się z pełną procedurą: poradnik dotyczący zbierania informacji zwrotnych od agentów AI obejmuje wszystkie dziesięć etykiet, weryfikację przez człowieka oraz sposób, w jaki zebrane dane są wykorzystywane podczas retrospektywy zespołu, a nie tylko w plikach kontekstowych.
- Proszę przyjrzeć się bliżej samej pętli: pętle informacji zwrotnej agentów odzwierciedlają cały obraz sytuacji: pętlę „wykrycie–naprawa”, narzędzia, które ją obsługują, oraz miejsce, jakie zajmuje w tym procesie sesja retro.
Warto zwrócić uwagę na jedną kwestię. Gdy agent zgłasza, że dokumentacja jest błędna, proszę to sprawdzić przed wprowadzeniem zmian, ponieważ czasami to dokumentacja jest poprawna, a agent ją błędnie zinterpretował. Nadal jest to przydatna wskazówka (zdanie, które łatwo błędnie zinterpretować, warto przeredagować), ale wymaga to innego rodzaju poprawki i właśnie dlatego w procesie tym nadal uczestniczy człowiek. Agent pełni rolę uczestnika, który sygnalizuje, co wzbudziło jego wątpliwości, ale nigdy nie jest autorytetem w kwestii tego, co powinien zawierać Państwa projekt.
Jakość Państwa plików kontekstowych zależy wyłącznie od ostatniej rzetelnej korekty. Agenci korzystający z nich przekazują Państwu te poprawki pod koniec każdej sesji. Wystarczy je tylko zapisać. A jeśli Państwa zespół chce, aby te poprawki znalazły się w miejscu, które jest już przeglądane przez innych, agent może przygotować swoje zalecenia i samodzielnie opublikować je na Państwa tablicy za pośrednictwem serwera TeamRetro MCP, po czym zostaną one przez Państwa potwierdzone i oznaczone [AI retro]symbolem obok pozostałych usprawnień zgłoszonych przez zespół.
Powiązane wpisy
- 23 września 2026CLAUDE.md dla zespołów: jak przekształciliśmy wspomnienia pięciu osób oparte na sztucznej inteligencji we wspólne zasady
- 18 lipca 2026Najlepsze narzędzia do oceny kondycji zespołu w 2026 roku
- 18 lipca 2026Nasi koledzy z zespołu AI dołączyli do naszej imprezy w stylu retro
- 16 lipca 2026Sztuczna inteligencja w agile project management: co powinny wiedzieć zespoły
- 13 lipca 2026Jak zebrać opinie od Państwa agentów opartych na sztucznej inteligencji
- 19 czerwca 2026Najlepsze narzędzia do współpracy dla zespołów pracujących zdalnie w 2026 roku (oraz element, którego brakuje w większości zestawów narzędzi)
- 16 czerwca 2026Ponad 60 lodołamaczy dla zespołów stosujących metodykę agile i Scrum
- 8 czerwca 202673 cytaty dotyczące pracy zespołowej, które zmotywują i zainspirują Państwa zespół