L'ingénierie contextuelle nécessite une boucle de rétroaction
Tout le monde rédige des fichiers CLAUDE.md et AGENTS.md, puis les laisse à l'abandon. L'ingénierie contextuelle ne comporte pas de cycle de maintenance. C'est l'agent qui vient de tomber sur ce document obsolète qui est le mieux placé pour le corriger.
L’ingénierie contextuelle est la discipline qui consiste à fournir à un agent d’IA les bonnes informations, sous la bonne forme et au bon moment, afin qu’il effectue correctement son travail au lieu de devoir deviner. Dans la pratique, pour la plupart des équipes, cela se traduit par des fichiers : un CLAUDE.mdà la racine du dépôt, un AGENTS.md, un dossier contenant les règles et conventions, ainsi qu’une invite système configurée une fois pour toutes par quelqu’un. Vous consignez le fonctionnement de votre projet afin que l’agent n’ait pas à le redécouvrir à chaque session.
C’est véritablement la mesure la plus efficace que vous puissiez prendre pour rendre les agents utiles. Et presque tous ceux qui s’y essaient sont confrontés au même problème tacite : ces fichiers deviennent obsolètes, et personne ne sait quelles parties sont concernées. Vous avez rédigé le contexte une fois, le code a évolué, et aujourd’hui, la moitié de ce contenu est discrètement erroné. Cette discipline comporte une phase de saisie, la rédaction du contexte, mais aucun cycle de maintenance. C’est cette lacune que traite cet article.
Le contexte, c’est le code, et le code se détériore
Nous savons déjà que la documentation devient rapidement obsolète. L’étape de compilation que vous avez documentée est remplacée, le dossier que vous avez décrit est renommé, la convention que vous avez consignée est supplantée, et la documentation continue de décrire avec assurance l’ancien état des lieux. Les fichiers de contexte sont encore pires que les documents ordinaires à cet égard, et ce pour deux raisons.
Tout d’abord, un agent les interprète à la lettre et agit en conséquence. Un humain, quant à lui, survole un fichier README obsolète, sent que quelque chose cloche et demande confirmation à quelqu’un. Un agent prend le fichier auCLAUDE.md pied de la lettre. S’il indique « exécuter make setup» et que cette cible a été supprimée au trimestre dernier, l’agent ne se pose pas de questions. Il perd du temps à essayer de faire fonctionner ce qui ne fonctionne pas, ou il invente une solution de contournement et passe à autre chose, en transmettant cette instruction erronée dans son résultat.
Deuxièmement, un contexte erroné est pire qu’un contexte manquant. Face à une lacune, l’agent peut parfois raisonner pour la contourner ou la signaler. En revanche, il se fie à une affirmation erronée présentée avec assurance. Les lignes les plus coûteuses dans vos fichiers de contexte ne sont pas celles qui manquent. Ce sont celles qui étaient autrefois vraies.
Vous avez donc besoin d’un cycle de maintenance. Le problème, c’est que les solutions habituelles ne fonctionnent pas. Vous n’allez pas procéder à un audit CLAUDE.mdligne par ligne selon un calendrier précis. Personne ne le fait. Vous ne remarquerez pas qu’il est obsolète à première vue, car il se lit très bien. L’obsolescence ne se révèle qu’au moment de son utilisation, à celui ou celle qui l’utilise. Et de plus en plus souvent, celui ou celle qui l’utilise n’est pas une personne.
Le seul témoin qui soit au courant
Voici le changement. L’agent qui vient d’exécuter une session sur votre projet est le seul participant à savoir, concrètement, quelles parties de votre contexte l’ont aidé et lesquelles l’ont induit en erreur. Il s’est contenté d’utiliser les fichiers. Il a exécuté la commande de compilation obsolète. Il a trouvé le dossier qui n’existe pas. Il a suivi le modèle qui s’est avéré être en réalité trois modèles différents. Cette connaissance ne dure qu’autant que la session, puis elle disparaît.
Personne ne vous indique quel contexte manque ou est erroné, à l’exception de l’élément qui vient d’en subir les conséquences. C’est là que réside la boucle de rétroaction, juste devant vous, sans que personne ne s’en empare. Il vous suffit de demander à l’agent de noter ce qu’il a appris avant la fin de la session, et de formuler votre demande de manière à ce que le résultat indique directement les fichiers à modifier.
Le journal rétrospectif de la session correspond à la boucle de maintenance
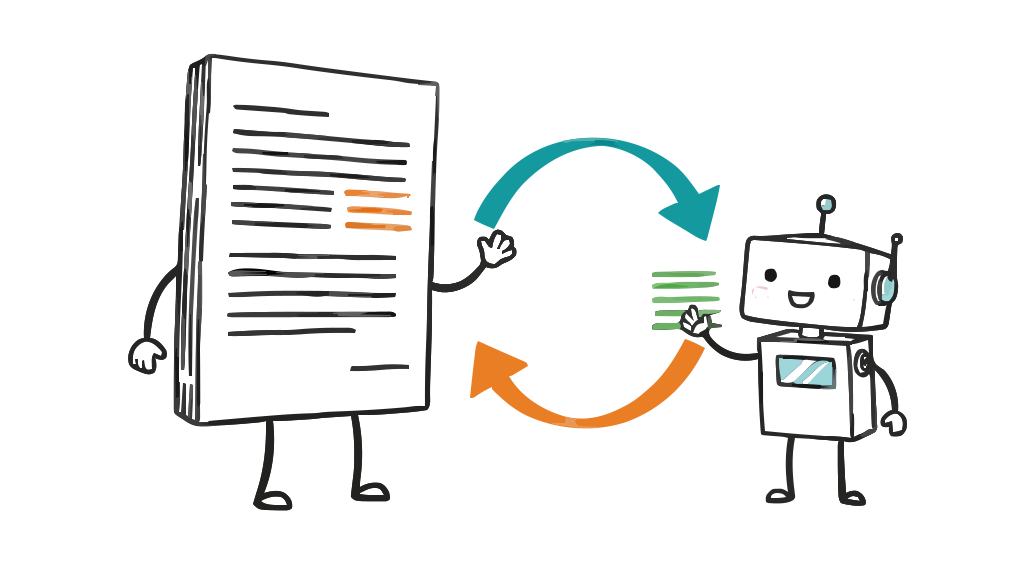
C’est exactement ce que produit une rétrospective IA de fin de session. À la fin d’une session de travail, l’agent rédige une brève note sincère : ce qui s’est bien passé, les points de friction rencontrés et, ce qui importe ici, chaque point de friction est associé à l’une des dix étiquettes de cause première prédéfinies et se termine par un « → À corriger : » de la taille d’un ticket. Deux de ces dix étiquettes renvoient directement à vos fichiers de contexte :
missing-documentation**** : l’agent avait besoin d’une information qui aurait dû figurer dans la documentation du projet, mais qui n’y figurait pas. Il s’agit de la liste des éléments à rédiger de votre fichier de contexte. Chacun de ces éléments correspond à une ligne que vous devriez ajouterCLAUDE.mdà votre documentation.incorrect-documentation**** : les documents existaient, mais étaient erronés ou obsolètes. Il s’agit de la liste des éléments à corriger de votre fichier de contexte. Chacun d’entre eux correspond à une ligne obsolète que l’agent a détectée de la seule manière possible : en l’utilisant et en se heurtant à un obstacle.
Ajoutez-y un troisième élément et vous aurez couvert l’essentiel des modifications dont vous aurez jamais besoin : ambiguous-instruction****, lorsqu’un mémoire ou une règle peut être interprété de plusieurs façons. C’est là que réside le cercle vicieux. Vous ne vérifiez pas vos fichiers de contexte selon un calendrier ; vous laissez les agents qui les utilisent vous indiquer, au moment même de leur utilisation, exactement quelles lignes modifier, avec les preuves jointes, car cette pratique repose exclusivement sur des références à des preuves.
Et il existe un quatrième indice qu’il est facile de négliger : les suppositions. Une bonne entrée répertorie tous les points où l’agent a comblé une lacune par une hypothèse. Chaque supposition correspond à un endroit où votre contexte était suffisamment lacunaire pour que l’agent doive inventer une réponse. Lisez une semaine de suppositions et vous obtiendrez une liste de tâches pour vos fichiers de contexte que vous n’auriez jamais pu rédiger vous-même, car vous connaissez déjà les réponses et ne pouvez donc pas voir où elles manquent.
Voici à quoi ressemble le résultat obtenu. Il s’agit d’un exemple à titre d’illustration, et non de données réelles :
## Friction
- CLAUDE.md says "run `make setup`" but that target was removed; the
  actual setup is `pnpm install && pnpm db:migrate`. Lost ~10 min.
  (incorrect-documentation)
  → Fix: Update the "Getting started" block in CLAUDE.md to the pnpm commands.
- Nothing documents that integration tests need the worker running.
  Found it by reading the CI config. (missing-documentation)
  → Fix: Add a "Running tests" note naming `pnpm worker` as a prerequisite.

## Guesses I made
- Assumed the `api/` package is the public surface and `internal/` is not,
  because nothing states it. Please confirm before I rely on it again.
Chaque ligne correspond à une modification spécifique apportée à un fichier précis. Il s’agit là d’une boucle de maintenance qu’une personne exécutera effectivement, car le travail consistant à identifier le problème, qui est la partie la plus coûteuse, est déjà effectué.
Pourquoi cette méthode est plus efficace que l’audit manuel
Vous pourriez essayer de maintenir les fichiers de contexte à jour à l’ancienne : planifier une révision, les lire de bout en bout, vérifier chaque affirmation par rapport à la réalité. Cela n’arrive jamais, et même lorsque c’est le cas, ce n’est pas la bonne méthode. En lisant un document de manière abstraite, vous ne pouvez pas déterminer quelles lignes sont obsolètes. Elles semblent toutes plausibles. C’est seulement en situation d’utilisation que l’obsolescence apparaît. Le journal rétrospectif est une maintenance du contexte guidée par l’utilisation réelle : seules les lignes qui ont effectivement déclenché une alerte sont signalées, ce qui vous permet de corriger ce qui ne fonctionne vraiment pas, au lieu de relire ce qui fonctionne déjà correctement. C’est la différence entre un détecteur de fumée et le fait de parcourir le bâtiment à la recherche de fumée.
Cela s’accumule également. Corrigez ces élémentsincorrect-documentation cette semaine et les sessions de la semaine prochaine se heurteront moins à ce problème, de sorte que le journal s’allonge moins et se concentre sur des problèmes plus profonds. Vos fichiers de contexte tendent à être plus précis, non pas parce que quelqu’un les a vérifiés, mais parce que les personnes et les agents qui les utilisent disposaient d’un moyen simple et structuré de signaler les écarts. C’est là une collaboration saine entre l’humain et l’IA : l’agent signale la dérive, l’humain décide de la modification. Ce même cycle s’applique également entre les personnes : nous avons mis en commun les mémoires privées de Claude Code de cinq développeurs et avons mis en avant les règles que plusieurs d’entre nous avaient notées indépendamment.
Lancez la boucle
Si vous investissez déjà dans l’ingénierie contextuelle, voici la pièce manquante du puzzle : la boucle de maintenance qui empêche cet investissement de se dégrader. Il s’agit d’un logiciel libre sous licence MIT :
- Téléchargez les compétences et le pack de prompts : github.com/TeamRetroHQ/teamretro-skills : une compétence Claude Code qui rédige l’entrée de fin de session, une autre qui synthétise les entrées en un résumé, ainsi qu’un pack de prompts indépendant de l’outil, compatible avec Cursor, GitHub Copilot ou tout autre agent auquel vous pouvez adresser des prompts.
- Découvrez la pratique dans son intégralité : comment recueillir les retours d’expérience de vos agents IA. Cette pratique couvre les dix étiquettes, la vérification par un humain et la manière dont ces informations alimentent une rétrospective d’équipe, et pas seulement vos fichiers de contexte.
- Approfondissons la question de la boucle elle-même : les boucles de rétroaction des agents permettent de dresser une vue d’ensemble du paysage : la boucle « de la capture à la correction », les outils qui la mettent en œuvre, et la place qu’y occupe une session.
Une nuance qu’il convient de garder à l’esprit. Lorsqu’un agent signale que les documents sont erronés, vérifiez-les avant de les modifier, car il arrive parfois que les documents soient corrects et que l’agent les ait mal interprétés. Cela reste néanmoins un indice utile (une ligne facile à mal interpréter mérite d’être réécrite), mais il s’agit d’une correction différente, et c’est pourquoi un humain doit rester impliqué dans le processus. L’agent est un intervenant qui signale ce qui a déclenché une alerte, jamais l’autorité qui décide de ce que votre projet doit dire.
La qualité de vos fichiers de contexte dépend entièrement de leur dernière correction valable. Les agents qui les utilisent vous transmettent ces corrections à la fin de chaque session. Il vous suffit de les noter. Et si votre équipe souhaite que ces corrections soient intégrées à un endroit où tout le monde les consulte déjà, l’agent peut préparer ses recommandations et les publier lui-même sur votre tableau via le serveur TeamRetro MCP ; vous n’aurez plus qu’à les valider en les marquant [AI retro]d’un « ☑ » à côté des autres améliorations proposées par votre équipe.
Articles similaires
- 23 septembre 2026CLAUDE.md pour les équipes : comment nous avons transformé les souvenirs générés par l'IA de cinq personnes en règles communes
- 18 juillet 2026Les meilleurs outils d'évaluation de la santé des équipes en 2026
- 18 juillet 2026Nos collègues IA se sont joints à notre événement rétro
- 16 juillet 2026L'IA dans la gestion de projet agile : ce que les équipes doivent savoir
- 13 juillet 2026Comment recueillir les retours d'expérience de vos agents IA
- 19 juin 2026Les meilleurs outils de collaboration pour les équipes à distance en 2026 (et la couche qui fait défaut à la plupart des piles technologiques)
- 16 juin 2026Plus de 60 questions pour brise-glace destinées aux équipes Agile et Scrum
- 8 juin 202673 citations sur le travail d'équipe pour motiver et inspirer votre équipe